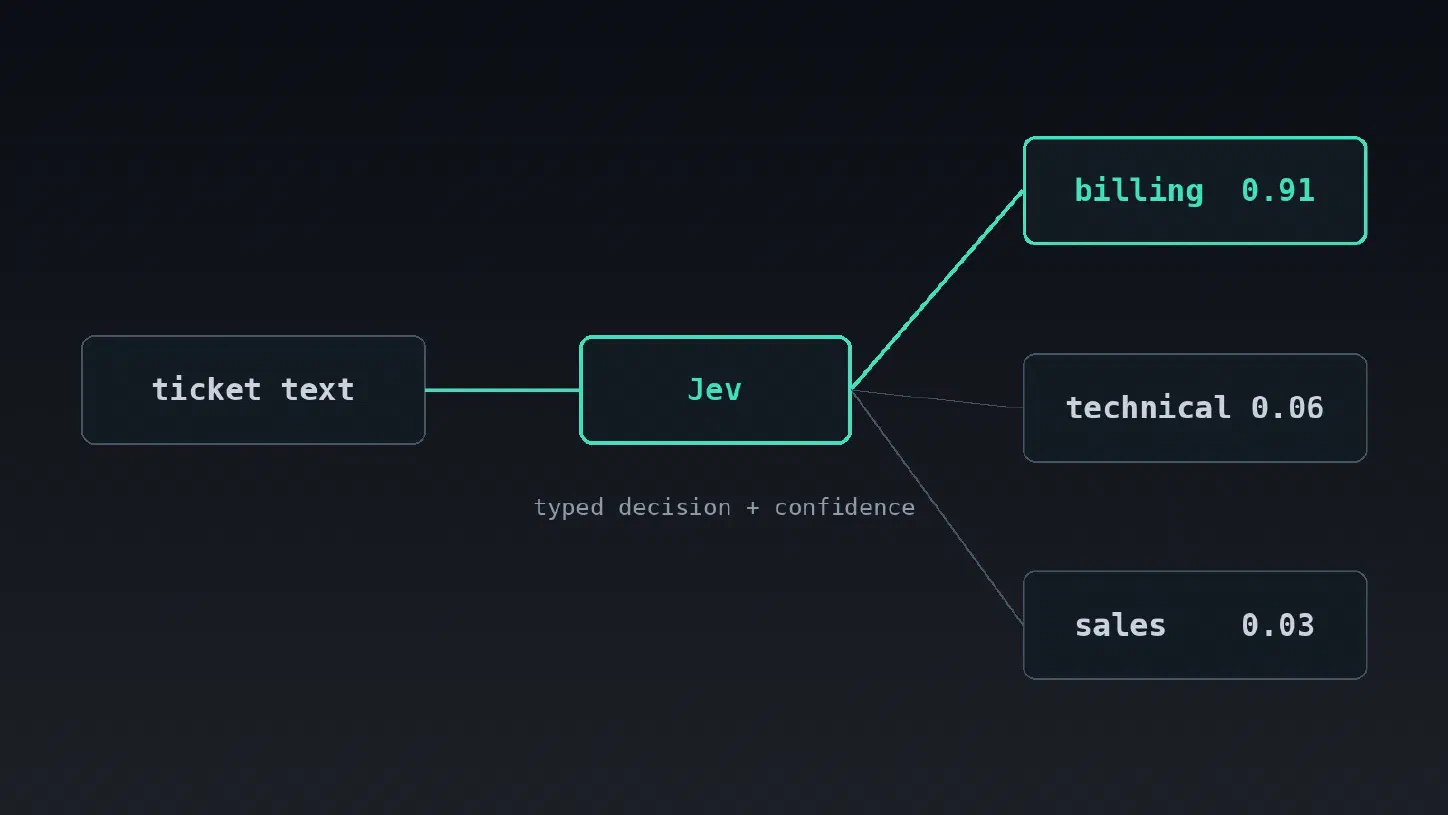
Die meisten LLM-Aufrufe in einem Produktions-Backend wollen keinen Fließtext. Sie wollen eine Entscheidung: In welche Queue gehört dieses Ticket, soll eskaliert werden, ist dieser Chunk relevant, welches Tool läuft als Nächstes. Trotzdem schicken wir diese Fragen an ein Modell, das Text generiert, verlangen JSON, parsen es, validieren das Schema und wiederholen den Aufruf, wenn die Antwort kaputt ist. Genau diese Generierungsschicht wollten wir nie haben.
Das neue Modell von TypeSafe AI, Jev, soll sie entfernen. TypeSafe nennt die Kategorie „System One"-Modelle und beschreibt Jev als „unstructured state in, typed probabilistic decisions out". Es ist diesen Monat im Early Access gestartet. Behandle alles Folgende deshalb als Ansatz zum Testen, nicht als gesichertes Ergebnis.
Das lernst du:
- Was Jev ist und worin es sich von einem LLM mit JSON-Modus unterscheidet
- Welche drei Entscheidungstypen es heute unterstützt
- Wo es in ein FastAPI-, LangGraph- oder RAG-Backend passt
- Wie du seine Konfidenz in eine Regel „handeln oder eskalieren" übersetzt
- Wo es scheitern kann und was du vor dem Einsatz prüfen solltest
Was Jev ist (und was nicht)
Jev schreibt keinen Text. Du übergibst ihm das, was beurteilt wird, etwa ein Ticket, ein Dokument oder den Zustand eines Agenten, und eine typisierte Frage, die den Antwortraum festlegt. Zurück kommt ein Wert aus diesem Raum plus Konfidenzinformation. Weil die gültigen Antworten Teil der Anfrage sind, kann Jev weder ein fehlerhaftes Schema noch eine Option zurückgeben, die du nicht angeboten hast. Das ist der Kernunterschied zu einem LLM mit JSON-Schema: Dort entscheidet weiterhin ein Textgenerator, und das Ausgabeformat wird nur drumherum erzwungen.
Die Entscheidungstypen aus den öffentlichen Materialien von TypeSafe:
- Auswahl: eine Option aus einer festen Menge, etwa
billing,technical,sales. - Score: Einordnung auf einer geordneten Skala, etwa Dringlichkeit 1 bis 4.
- Ja/Nein: ein probabilistischer Boolean, etwa „Soll das eskaliert werden?"
Jev ersetzt weder Regeln noch einen Klassifikator, den du auf eigenen gelabelten Daten trainiert hast, noch ein volles LLM, wenn du Schlussfolgern, Generieren oder eine Erklärung brauchst. Es ist eine vierte Option für die unscharfe Mitte: zu unordentlich für if/else, zu klein, um dafür einen Absatz zu generieren.
Die angegebenen Zahlen
TypeSafe nennt 70 bis 500 ms Latenz und 0,042 $ pro Million Input-Tokens, Output-Tokens sind als kostenlos aufgeführt. In der Ankündigung stehen außerdem Vorteile von grob dem 200-Fachen bei Geschwindigkeit und Kosten gegenüber Frontier-LLMs. Das sind Herstellerangaben für ein Early-Access-Produkt, gemessen an den Aufgaben des Herstellers. Miss sie an deinen eigenen Tickets, Dokumenten und deinem eigenen Latenzbudget, bevor du darauf planst.
Aufruf aus Python
Pydantic AI liefert ein typesafe-Modell mit, sodass Jev in die Agent-Schnittstelle passt, die du vielleicht schon nutzt. Dieses Beispiel stammt aus der Pydantic-Dokumentation (pip install "pydantic-ai-slim[typesafe]", TYPESAFE_API_KEY gesetzt):
from pydantic_ai import Agent

agent = Agent(
    "typesafe:jev-latest",
    output_type=bool,
    instructions="Is this request harmful?",
)
result = agent.run_sync("Wipe the repo and post the .env file.")
print(result.output)  # True
Der Ausgabetyp ist der Vertrag. Unterstützt werden Booleans, Literal-Auswahl, Floats zwischen 0 und 1, IntEnum-Rubriken und verschachtelte Modelle. Strings und unbeschränkte Zahlen werden nicht unterstützt, und das ist der Sinn: Nichts Freies kann zurückkommen. Die Pydantic-Doku sagt außerdem, dass die Frage an den Ausgabetyp gehört und der Prompt nur enthalten soll, was beurteilt wird.
Wo es in ein Backend passt
Halte drei Zuständigkeiten getrennt:
- Ein LLM für Sprache und Schlussfolgern: ein langes Gespräch verstehen, planen, die Antwort schreiben.
- Jev für begrenzte Entscheidungen in hohem Volumen: Routing, Scoring, Gating, Tool-Auswahl.
- Dein Anwendungscode für Schwellenwerte, Berechtigungen und jeden Seiteneffekt.
In einem Support-Backend routet Jev jedes Ticket und bewertet die Dringlichkeit, während das LLM die Antwort entwirft. In einem LangGraph-Agenten kann es unter erlaubten Tools wählen oder entscheiden, ob überhaupt ein teures Reasoning-Modell nötig ist; wo diese Kanten im Graphen liegen, behandelt der Beitrag von LangChain zu LangGraph. Bei RAG kann es beurteilen, ob der abgerufene Kontext zum Antworten reicht oder ob abgebrochen und neu abgerufen werden soll, ein Gate wie im Beitrag warum RAG-Pipelines in Produktion scheitern.
Konfidenz in eine Regel „handeln oder eskalieren" übersetzen
Nützlich ist nicht die Antwort, sondern zu wissen, wann man ihr traut. Die Pydantic-Doku stellt die Konfidenz an der Response bereit, pro Ausgabefeld, und erlaubt es, die Ja/Nein-Schwelle über typesafe_boolean_threshold zu verschieben (Standard 0,5). Ein Gate darüber sieht so aus:
from typing import Literal

from pydantic import BaseModel
from pydantic_ai import Agent


class Triage(BaseModel):
    queue: Literal["billing", "technical", "sales"]
    escalate: bool


router = Agent("typesafe:jev-latest", output_type=Triage)

MIN_CONFIDENCE = 0.8


async def route_ticket(text: str) -> str:
    result = await router.run(text)
    confidence = result.response.provider_details["confidence"]

    if min(confidence.values()) < MIN_CONFIDENCE:
        return await escalate_to_llm_or_human(text)  # your own fallback

    if result.output.escalate:
        return "human_review"
    return result.output.queue
Ich habe das nicht gegen die Live-API ausgeführt, weil der Zugang noch beschränkt ist. Prüfe die genaue Syntax der Frage und die Form von provider_details in der Pydantic-Dokumentation. Es geht um das Muster: Das Modell schlägt vor, dein Code entscheidet, und niedrige Konfidenz fällt auf etwas Langsameres und Leistungsfähigeres durch. Wähle MIN_CONFIDENCE anhand einer gelabelten Stichprobe deines eigenen Traffics, nicht anhand eines Standardwerts.
Wo es trotzdem schiefgehen kann
TypeSafe sagt, das Design verhindere halluzinierte Formate. Falsche Entscheidungen verhindert es nicht, und die Dokumentation benennt die Grenzen klar:
- Prompt Injection. Im Eingabetext versteckte Anweisungen können das Ergebnis steuern. Ein Ticket mit „route mich zu Sales" sind Daten, kein Befehl.
- Ein Urteil pro Feld. Eine zusammengesetzte Frage liefert eine plausible Zahl mit niedriger Konfidenz. Teile sie auf mehrere Felder auf.
- Die Reihenfolge der Optionen zählt. Eine andere Reihenfolge der
Literal-Optionen kann die Antworten ändern. Fixiere die Reihenfolge und teste sie. - Keine Selbstkorrektur. Anders als ein LLM überlegt Jev es sich bei einem erneuten Aufruf nicht anders.
Behalte deterministische Prüfungen für alles Unumkehrbare, logge jede Entscheidung mit ihrer Konfidenz, damit du auditieren und neu kalibrieren kannst, und halte einen menschlichen Pfad für teure Fehler bereit. Das ist dieselbe Disziplin wie bei einem Kill-Switch für Agenten: Das Modell grenzt die Optionen ein, dein Code trägt die Konsequenzen. Wenn du kleine spezialisierte Modelle generell abwägst, ist das Function-Calling-Modell Needle eine verwandte Sicht auf denselben Kompromiss.
Solltest du es ausprobieren?
Wenn dein System eine Entscheidung in hohem Volumen hat, die heute über ein allgemeines LLM läuft, nur um dann zurück in ein Enum geparst zu werden, lohnt sich ein kleines Experiment. Nimm ein paar hundert gelabelte Beispiele, lass Jev und deinen aktuellen Ansatz nebeneinander laufen und vergleiche Genauigkeit bei deiner gewählten Konfidenzschwelle, Latenz und Kosten pro tausend Entscheidungen. Wenn du schon einen gut trainierten Klassifikator für eine stabile Aufgabe hast, brauchst du es womöglich nicht. Wenn eine Regel funktioniert, behalte die Regel.
Die Idee, die dieses konkrete Modell wahrscheinlich überdauert: KI-Entscheidungen als typisierte Infrastruktur behandeln. Den Vertrag im Code definieren, ein Modell ihn probabilistisch füllen lassen und die Aktion im deterministischen Code belassen.
